
IA, sites web et visibilité numérique
Votre site a trois portes. L’IA essaiera les trois.
Robots de recherche, agents personnels et robots d’entraînement ont des rôles différents. Rendez votre site utile, accessible et clair sur vos choix.
Digitrans · · 10 min de lecture
Trois types de visiteurs, trois décisions différentes.
Dans cet article
Un prospect demande à un assistant IA quelle entreprise luxembourgeoise peut automatiser ses factures. L’assistant lance une recherche. Un autre client charge un agent de comparer des fournisseurs. Une entreprise d’IA collecte des pages publiques pour entraîner un modèle. Trois visites, trois objectifs, et parfois trois règles différentes.
Pour rendre un site visible dans la recherche IA et utilisable par les agents, il faut décider ce que chaque visiteur peut faire, puis proposer des informations qui méritent d’être trouvées. Ajouter « IA » au titre de la page d’accueil ne suffit pas.
Recherche, agents et entraînement : trois choix
| Visiteur | Fonction | Décision |
|---|---|---|
| Robot de recherche | Découvre des pages pour un index ou une recherche IA. | Peut-il trouver et indexer les pages publiques pertinentes ? |
| Agent utilisateur ou navigateur | Consulte ou utilise une page pour une personne. | Peut-il lire la page et suivre le parcours voulu ? |
| Robot d’entraînement | Collecte des contenus pouvant servir à entraîner un modèle. | Souhaitez-vous exprimer un refus ou autoriser l’accès ? |
Ces catégories peuvent se recouper. Un robot à usage mixte peut avoir plusieurs fonctions. Autoriser une requête ne garantit ni visite, ni citation, ni entraînement. Un pare-feu peut encore bloquer une requête et l’accès public ne donne pas accès aux comptes privés.
OpenAI distingue OAI-SearchBot, GPTBot et ChatGPT-User. Le premier sert à la recherche dans ChatGPT, GPTBot collecte des contenus susceptibles de servir à l’entraînement et ChatGPT-User peut consulter une page à la demande d’une personne. Selon OpenAI, les règles robots peuvent ne pas s’appliquer aux requêtes initiées par un utilisateur. Un seul bouton ne contrôle pas tous les services.
Le nouveau signal commun pour l’entraînement
Le 30 octobre 2026, Google et OpenAI ont annoncé leur soutien à une préférence commune dans robots.txt. Le projet de l’IETF propose le jeton User-Agent: __usage_ai-training, associé aux règles de chemin Allow et Disallow. La règle Disallow: / dans ce groupe permettrait d’exprimer un refus d’entraînement aux fournisseurs participants.
Il s’agit d’un projet, pas d’une norme achevée ni d’un mécanisme universel. OpenAI vise une mise en œuvre dans les prochains mois et Google en 2027. Les contrôles propres aux fournisseurs restent utiles. Google prévoit d’interpréter le refus commun comme un refus de Google-Extended, sauf indication explicite différente pour celui-ci. Vérifiez la documentation à jour avant toute modification.
Le signal proposé concerne l’entraînement, pas automatiquement la recherche, les réponses IA, les agents ou tous les usages du contenu. L’absence de groupe n’exprime aucune préférence par ce signal. Documentez votre choix et réexaminez-le lorsque les mises en œuvre évoluent.
Un exemple réel : deux versions de notre porte d’entrée
Le 6 novembre 2026, le robots.txt public de Digitrans contenait à la fois Disallow: / et Allow: / pour GPTBot, ClaudeBot et Google-Extended. Le 8 novembre, nous avons confirmé que le préfixe géré par Cloudflare ajoutait aussi ai-train=no, alors que notre fichier d’origine autorisait les robots nommés. Selon la RFC 9309, les groupes correspondants sont fusionnés et une règle Allow équivalente devrait prévaloir. Cela décrit l’interprétation prévue, pas le comportement observé de chaque robot.
Nous avons choisi d’autoriser l’entraînement, la recherche et les agents. Nous avons désactivé Bot Preference Sync, qui ajoutait les règles contradictoires, et défini la politique Training sur Allow. Le fichier public affichait ensuite nos règles d’origine sans le préfixe géré. Le panneau ci-dessous montre les choix enregistrés. D’autres règles de sécurité peuvent encore affecter les requêtes et ce réglage ne prouve pas qu’un robot a visité le site ou utilisé son contenu.
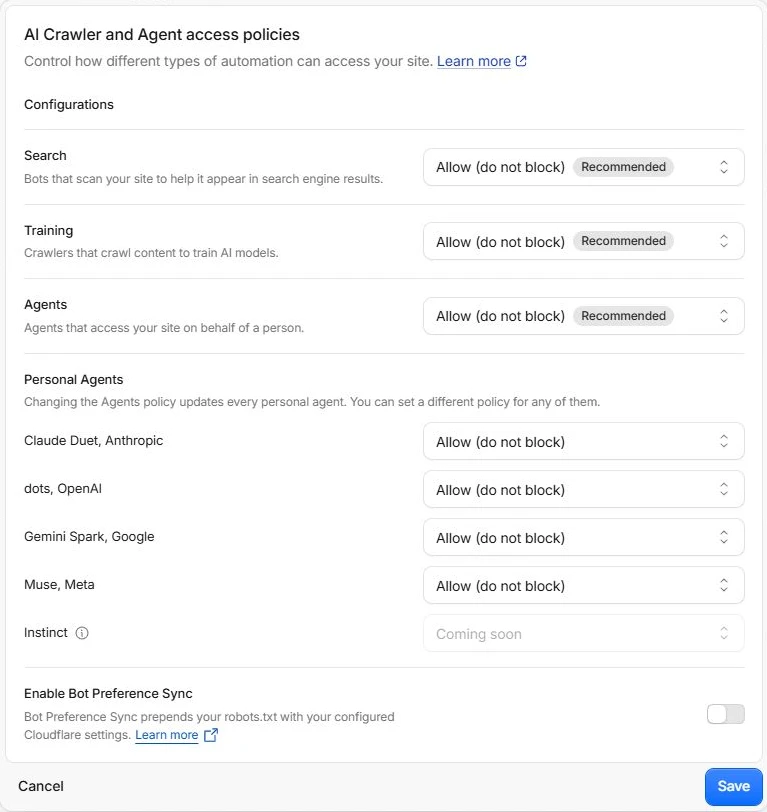
Nos réglages Cloudflare le 8 novembre 2026. Recherche, entraînement et agents sont des choix distincts, avec des contrôles individuels pour certains agents. Interface en anglais.
Voir en grand formatCloudflare explique que Bot Preference Sync peut ajouter des règles et, avec le refus d’entraînement, activer un blocage à la périphérie du réseau. Vérifiez donc le fichier public et la politique du CDN ou du pare-feu. Votre entreprise peut choisir une autre politique d’entraînement.
Avec Cloudflare : trouver les bons réglages
Cloudflare est une option intéressante pour de nombreux sites professionnels : DNS, cache, outils de sécurité et contrôles des robots. Selon W3Techs, au 8 novembre 2026, 28,7 % des sites étudiés utilisaient Cloudflare et celui-ci représentait 86,3 % des sites dont le proxy inverse était connu. Ce second chiffre concerne ce sous-ensemble, pas tous les sites.
Dans Cloudflare, sélectionnez le domaine, ouvrez Security puis Settings, filtrez Bot traffic et ouvrez AI Crawler and Agent access policies. Examinez Search, Training et Agents séparément, ainsi que les exceptions par agent. Consultez AI Crawl Control et Bot Preference Sync. Enregistrez les choix voulus, relisez le robots.txt public et examinez les événements de sécurité pour identifier les blocages réels. Ne désactivez pas les protections sans rapport.
Si vous n’utilisez pas de CDN, envisagez Cloudflare, y compris son offre gratuite si elle convient. Vous pouvez généralement conserver votre registrar et votre hébergeur. Une configuration courante déplace le DNS faisant autorité vers Cloudflare et fait passer certains enregistrements web par son proxy. Inventoriez et recopiez d’abord tous les enregistrements DNS, notamment ceux du courrier et de vérification, contrôlez DNSSEC avec le registrar et suivez les instructions de Cloudflare. Testez site, courrier et certificats après migration. Une erreur DNS ou DNSSEC peut interrompre les services. Cloudflare n’est pas obligatoire pour être visible en IA.
Sans Cloudflare : commencez chez l’hébergeur
Le registrar gère l’enregistrement du domaine et souvent le choix des serveurs DNS. Le DNS dirige les noms vers les services. L’hébergeur sert le site et peut proposer son propre pare-feu, cache ou constructeur. Ces fonctions peuvent relever d’un ou plusieurs prestataires. Modifier une entrée DNS ne modifie pas le fichier robots.txt.
Sur un hébergement classique, trouvez la racine publique du nom d’hôte dans le panneau d’hébergement ou par SFTP, sauvegardez le fichier existant et modifiez-le. Avec un CMS, un générateur de site statique ou un constructeur hébergé, utilisez ses réglages SEO ou sa source de déploiement pour éviter qu’une publication ultérieure n’écrase le changement. Évitez les fichiers concurrents. Google explique l’emplacement et la portée du fichier. Contrôlez le domaine et son éventuel sous-domaine www, et demandez à l’hébergeur comment il filtre les robots. Un hébergement ordinaire peut suffire.
Créez des pages qui méritent d’être trouvées
Un cabinet comptable luxembourgeois cherche à traiter ses factures entrantes. « Nous renforçons la transformation intelligente » ne répond pas à sa question. Une page utile décrit les documents reçus, les données extraites, les intégrations ou exports disponibles, le moment du contrôle humain et la façon de demander une démonstration. Précisez les conditions liées au déploiement.
- Donnez à chaque offre une page claire, un titre descriptif et une réponse directe sur son public et sa fonction.
- Ajoutez exemples, limites, dates et sources lorsque ces éléments aident à vérifier une affirmation. Gardez prix et coordonnées à jour.
- Utilisez titres, HTML lisible, liens explicites, descriptions d’images et mise en page mobile. Reliez services, guides et articles pertinents.
- Présentez une prochaine étape claire. Ne cachez pas les informations essentielles uniquement dans une image ou une vidéo.
- Adaptez langues et contexte local : au Luxembourg, les recherches peuvent être faites en français, allemand ou anglais.
Pour ses fonctions IA, Google recommande les fondamentaux du référencement : pages accessibles, contenu utile et configuration technique saine. L’éligibilité ne garantit pas une présence. Les autres fournisseurs utilisent leurs propres systèmes.
Vérifiez la technique avant d’acheter un miracle SEO
Ouvrez https://votre-domaine/robots.txt. Cherchez les groupes applicables, les doublons et les règles de chemin plus spécifiques. Vérifiez le fichier servi publiquement et les éventuels blocages du CDN. Une règle Disallow n’est ni une authentification ni une protection pour des données sensibles.
Contrôlez les réponses HTTP, URL canoniques, liens internes, sitemap et état d’indexation dans Search Console. Une page bloquée au crawl ne peut pas communiquer de façon fiable une directive noindex à un robot qui ne la voit pas. Testez plusieurs pages et analysez séparément les défis, blocages et erreurs serveur.
Les données structurées doivent refléter le contenu visible et respecter la documentation applicable. Elles ne garantissent ni résultat enrichi ni citation IA. Un fichier llms.txt peut servir d’index aux systèmes qui le lisent, mais Google indique ne pas l’utiliser pour Search. Aucun balisage secret, nombre de mots idéal ou découpage obligatoire en petits paragraphes n’est nécessaire.
Un agent peut-il vraiment utiliser votre site ?
Un agent peut comparer des offres, chercher des disponibilités ou commencer une demande pour un client. Il lui faut des textes clairs, des libellés explicites, des commandes accessibles, une navigation prévisible et des erreurs compréhensibles. Affichez les prix et conditions essentiels, identifiez les champs obligatoires et prévoyez un contact humain. Testez aussi le parcours au clavier et sur mobile.
Autoriser l’accès à une page publique ne permet pas de contourner une connexion, d’extraire des données privées, de conclure un contrat ou d’acheter. Les actions sensibles exigent authentification, permissions et confirmation appropriées. CAPTCHA, limites de débit et protections anti-abus ont leur utilité. Vérifiez les obstacles inutiles sans démanteler la sécurité. Une chaîne user-agent ne prouve pas à elle seule une identité.
Mesurez les résultats utiles
Suivez l’indexation, les rapports de recherche, les visites référées disponibles, les demandes et les résultats commerciaux. Certains assistants ne transmettent pas de source identifiable. Une mention sans clic peut aussi influencer une décision. Demandez aux clients comment ils vous ont trouvé, sans considérer leurs réponses comme une mesure parfaite. Répétez quelques questions pertinentes en plusieurs langues, en notant la date et le service utilisé.
Une requête réussie ne prouve ni indexation, ni citation, ni vente. Établissez une référence, améliorez une page, laissez le temps au recrawl et cherchez des tendances. Respectez la vie privée dans la mesure.
Un premier après-midi pratique
- Listez les pages et publics importants : services, produits, assistance, langues et informations locales.
- Comparez robots.txt public, règles des fournisseurs et politiques du CDN pour la recherche, les agents et l’entraînement. Documentez les décisions.
- Vérifiez quelques URL : réponse, indexation, canonique, contenu clair et liens internes.
- Demandez à une personne de trouver une réponse et de commencer une demande sur mobile et au clavier ; testez aussi un agent si possible.
- Améliorez une page avec des réponses concrètes, des preuves et une prochaine étape, puis vérifiez-la après publication.
Digitrans aide les entreprises luxembourgeoises à améliorer leurs sites, leur visibilité et leurs parcours clients adaptés à l’IA. Parlons de votre site.
Questions fréquentes
Faut-il autoriser l’entraînement pour apparaître dans la recherche IA ?
Pas nécessairement. Certains fournisseurs séparent recherche et entraînement. OpenAI documente OAI-SearchBot et GPTBot séparément. Vérifiez les règles actuelles et les robots à usage mixte.
Autoriser GPTBot garantit-il une recommandation dans ChatGPT ?
Non. GPTBot concerne un éventuel entraînement. La recherche utilise des contrôles et systèmes distincts. L’accès ne garantit ni recommandation ni citation.
Faut-il bloquer tous les agents IA ?
Cela dépend de vos services et risques. Les agents peuvent aider des clients à utiliser les informations publiques. Protégez les données privées et actions sensibles et testez l’accès légitime.
Le nouveau signal commun est-il obligatoire ?
Non. La proposition citée est un projet et les mises en œuvre annoncées sont volontaires et futures. Les calendriers peuvent évoluer.
llms.txt améliore-t-il le classement IA de Google ?
Google indique que Search ne l’utilise pas. D’autres systèmes peuvent choisir de le lire, mais il ne remplace pas des pages accessibles et utiles.
Digitrans peut-il aider à améliorer la visibilité IA ?
Oui. Nous pouvons examiner l’accès, les fondamentaux SEO, le contenu et les parcours des agents, puis mettre en œuvre des améliorations adaptées. Aucun fournisseur ne peut garantir une réponse ou un classement précis.