
KI, Websites und digitale Sichtbarkeit
Ihre Website hat drei Türen. Die KI wird alle ausprobieren.
Such-Crawler, persönliche Agenten und Trainings-Bots haben unterschiedliche Aufgaben. Machen Sie Ihre Website nützlich, zugänglich und Ihre Entscheidungen klar.
Digitrans · · 9 Min. Lesezeit
Drei Arten von Besuchern, drei unterschiedliche Entscheidungen.
In diesem Artikel
Ein Interessent fragt einen KI-Assistenten, welches Unternehmen in Luxemburg Rechnungen automatisieren kann. Der Assistent sucht. Ein anderer Kunde beauftragt einen Agenten mit dem Vergleich von Anbietern. Ein KI-Unternehmen sammelt öffentliche Seiten für das Modelltraining. Drei Besuche, drei Zwecke und möglicherweise drei verschiedene Regeln.
Damit eine Website in der KI-Suche sichtbar und für Agenten nutzbar ist, müssen Sie entscheiden, was die jeweiligen Besucher tun dürfen. Danach brauchen sie Informationen, die sich zu finden lohnen. Das Wort „KI“ im Titel der Startseite genügt nicht.
Suche, Agenten und Training sind getrennte Entscheidungen
| Besucher | Aufgabe | Entscheidung |
|---|---|---|
| Such-Crawler | Findet Seiten für einen Suchindex oder eine KI-Suche. | Darf der Dienst relevante öffentliche Seiten finden und indexieren? |
| Nutzer- oder Browser-Agent | Liest oder bedient eine Seite für eine Person. | Kann er die Seite lesen und den gewünschten Ablauf nutzen? |
| Trainings-Crawler | Sammelt Inhalte, die zum Training eines Modells dienen können. | Möchten Sie einen Widerspruch ausdrücken oder Zugang erlauben? |
Die Kategorien können sich überschneiden. Ein Crawler mit mehreren Zwecken kann mehrere Funktionen erfüllen. Eine Erlaubnis garantiert weder Besuch noch Zitat oder Training. Eine Firewall kann Anfragen weiterhin blockieren und der Zugang zu öffentlichen Seiten öffnet keine privaten Konten.
OpenAI unterscheidet OAI-SearchBot, GPTBot und ChatGPT-User. OAI-SearchBot unterstützt die Suche in ChatGPT, GPTBot sammelt möglicherweise für das Training verwendete Inhalte, und ChatGPT-User kann Seiten auf Anfrage eines Nutzers abrufen. Laut OpenAI gelten robots-Regeln bei nutzerinitiierten Anfragen möglicherweise nicht. Ein Schalter steuert nicht alle Dienste.
Das neue gemeinsame Signal für KI-Training
Am 30. Oktober 2026 kündigten Google und OpenAI Unterstützung für eine gemeinsame Trainingspräferenz in robots.txt an. Der IETF-Internetentwurf schlägt das Token User-Agent: __usage_ai-training mit den bekannten Pfadregeln Allow und Disallow vor. Disallow: / in dieser Gruppe könnte teilnehmenden Anbietern einen Trainingswiderspruch anzeigen.
Der Entwurf ist weder ein abgeschlossener Standard noch eine universelle Durchsetzung. OpenAI strebt die Umsetzung in den kommenden Monaten an, Google im Jahr 2027. Anbieterbezogene Regeln bleiben relevant. Google will den gemeinsamen Widerspruch bei Unterstützung wie ein Google-Extended-Verbot behandeln, sofern Google-Extended nicht ausdrücklich anders eingestellt ist. Prüfen Sie vor Änderungen die aktuelle Dokumentation.
Das geplante Signal betrifft Training, nicht automatisch Suche, KI-Antworten, Agenten oder jede andere Inhaltsnutzung. Fehlt die Gruppe, wird über dieses Signal keine Präferenz ausgedrückt. Dokumentieren Sie Ihre Wahl und prüfen Sie sie erneut, wenn sich die Implementierungen ändern.
Ein echtes Beispiel: zwei Versionen unserer Eingangstür
Am 6. November 2026 enthielt die öffentliche robots.txt von Digitrans für GPTBot, ClaudeBot und Google-Extended sowohl Disallow: / als auch Allow: /. Am 8. November bestätigten wir, dass der von Cloudflare verwaltete Vorspann zusätzlich ai-train=no enthielt, während unsere Ursprungsdatei die genannten Bots erlaubte. Nach RFC 9309 werden passende Gruppen zusammengeführt und eine gleichwertige Allow-Regel sollte Vorrang haben. Das beschreibt die vorgesehene Auslegung, nicht das tatsächliche Verhalten jedes Crawlers.
Wir haben uns entschieden, Training, Suche und Agenten zu erlauben. Wir deaktivierten Bot Preference Sync, das die widersprüchlichen Regeln voranstellte, und stellten die separate Training-Richtlinie auf Allow. Die öffentliche Datei zeigte danach die Ursprungsregeln ohne verwalteten Vorspann. Das folgende Fenster zeigt die gespeicherten Einstellungen. Andere Sicherheitsregeln können Anfragen weiterhin beeinflussen. Eine Einstellung beweist keinen erneuten Besuch oder eine Nutzung unserer Inhalte.
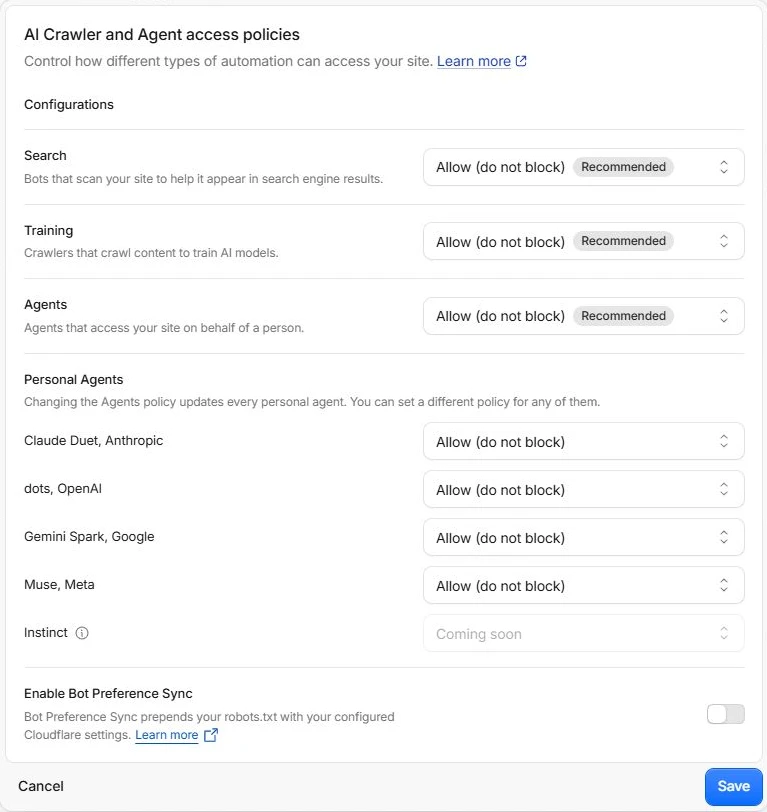
Unsere Cloudflare-Einstellungen am 8. November 2026. Suche, Training und Agenten sind getrennte Entscheidungen; für einzelne persönliche Agenten gibt es eigene Einstellungen. Oberfläche auf Englisch.
In voller Größe ansehenCloudflare erklärt, dass Bot Preference Sync verwaltete Regeln hinzufügen und bei einem Trainingsverbot auch Crawler am Netzwerkrand blockieren kann. Prüfen Sie daher die öffentliche Datei und die CDN- oder Firewall-Richtlinie. Ihr Unternehmen kann sich beim Training anders entscheiden.
Mit Cloudflare: die richtigen Einstellungen finden
Cloudflare ist für viele Unternehmenswebsites eine sinnvolle Option und verbindet DNS, Cache, Sicherheitswerkzeuge und Crawler-Steuerung. W3Techs zufolge nutzten am 8. November 2026 28,7 % der untersuchten Websites Cloudflare. Unter den Websites mit bekanntem Reverse-Proxy-Dienst lag der Anteil bei 86,3 %. Der zweite Wert bezieht sich auf diese Teilmenge, nicht auf alle Websites.
Wählen Sie in Cloudflare Ihre Domain, öffnen Sie Security und Settings, filtern Sie nach Bot traffic und öffnen Sie AI Crawler and Agent access policies. Prüfen Sie Search, Training und Agents getrennt sowie Ausnahmen für einzelne Agenten. Sehen Sie sich AI Crawl Control und Bot Preference Sync an. Speichern Sie nur die gewünschten Einstellungen, lesen Sie die öffentliche robots.txt erneut und prüfen Sie Sicherheitsereignisse auf tatsächliche Blockierungen. Deaktivieren Sie keine sachfremden Schutzmaßnahmen.
Wenn Sie noch kein CDN nutzen, empfehlen wir, Cloudflare einschließlich des kostenlosen Tarifs zu prüfen, sofern er passt. Registrar und Hosting können normalerweise bleiben. Bei einer üblichen Einrichtung wird das autoritative DNS zu Cloudflare verlagert und ausgewählte Website-Einträge werden über den Proxy geleitet. Erfassen und übernehmen Sie zuvor alle DNS-Einträge, auch für E-Mail und Verifizierung, prüfen Sie DNSSEC beim Registrar und befolgen Sie die Cloudflare-Anleitung. Testen Sie danach Website, E-Mail und Zertifikate. Fehler bei DNS oder DNSSEC können Dienste unterbrechen. Cloudflare ist keine Voraussetzung für KI-Sichtbarkeit.
Ohne Cloudflare: beim Hoster anfangen
Der Registrar verwaltet die Domainregistrierung und häufig die Auswahl der Nameserver. DNS verweist Namen auf Dienste. Der Hoster liefert die Website aus und kann eigene Firewall-, Cache- oder Baukastenfunktionen anbieten. Das kann ein Unternehmen oder mehrere betreffen. Ein DNS-Eintrag beim Registrar ändert nicht die robots.txt Ihrer Website.
Suchen Sie bei klassischem Hosting im Hosting-Panel oder per SFTP das öffentliche Stammverzeichnis des jeweiligen Hostnamens, sichern Sie die vorhandene Datei und bearbeiten Sie sie dort. Bei CMS, statischen Generatoren und Website-Baukästen nutzen Sie deren SEO-Einstellungen oder Deployment-Quelle, damit die nächste Veröffentlichung die Änderung nicht überschreibt. Vermeiden Sie konkurrierende Dateien. Google erklärt Speicherort und Geltungsbereich. Prüfen Sie Domain und gegebenenfalls www-Subdomain und fragen Sie den Hoster nach seiner Bot-Filterung. Gewöhnliches Hosting kann genügen.
Erstellen Sie Seiten, die sich zu finden lohnen
Eine Luxemburger Buchhaltungskanzlei sucht eine Lösung für eingehende Rechnungen. „Wir ermöglichen intelligente Transformation“ beantwortet ihre Frage nicht. Eine hilfreiche Seite erklärt Eingangskanäle, extrahierte Daten, verfügbare Integrationen oder Exporte, menschliche Kontrolle und die Anfrage einer Demonstration. Nennen Sie Abhängigkeiten von Deployment oder Integration.
- Geben Sie jedem wichtigen Angebot eine klare Seite, einen aussagekräftigen Titel und eine direkte Antwort zu Zielgruppe und Funktion.
- Ergänzen Sie konkrete Beispiele, Grenzen, Daten und Quellen, wenn sie Aussagen überprüfbar machen. Halten Sie Preise und Kontaktdaten aktuell.
- Verwenden Sie verständliche Überschriften, lesbares HTML, aussagekräftige Links, Bildbeschreibungen und mobile Layouts. Verknüpfen Sie passende Dienste, Anleitungen und Artikel.
- Machen Sie den nächsten Schritt sichtbar. Verstecken Sie wesentliche Angaben nicht ausschließlich in Bildern oder Videos.
- Berücksichtigen Sie Sprachen und lokalen Kontext: In Luxemburg wird unter anderem auf Deutsch, Französisch und Englisch gesucht.
Für seine KI-Funktionen empfiehlt Google die Grundlagen der Suchoptimierung: zugängliche Seiten, hilfreiche Inhalte und eine saubere technische Einrichtung. Eine Eignung garantiert keine Anzeige. Andere Anbieter verwenden eigene Systeme.
Technik prüfen, bevor Sie ein KI-SEO-Wunder kaufen
Öffnen Sie https://ihre-domain/robots.txt. Suchen Sie nach passenden Gruppen, doppelten Gruppen und spezifischeren Pfadregeln. Prüfen Sie die öffentlich ausgelieferte Datei sowie mögliche CDN-Blockierungen. Eine Disallow-Regel ist weder Authentifizierung noch ein Schutz für vertrauliche Daten.
Prüfen Sie HTTP-Antworten, kanonische URLs, interne Links, Sitemap und Indexierung in der Search Console. Eine für Crawling gesperrte Seite kann einem Crawler, der sie nicht sieht, eine noindex-Anweisung nicht zuverlässig übermitteln. Testen Sie mehrere Seiten und untersuchen Sie Challenges, Blockierungen und Serverfehler gesondert.
Strukturierte Daten müssen sichtbare Informationen wiedergeben und der jeweiligen Dokumentation entsprechen. Sie garantieren weder Rich Results noch KI-Zitate. Eine llms.txt kann ein Index für Systeme sein, die sie lesen; Google nutzt sie nach eigener Aussage nicht für Search. Geheimes KI-Markup, eine ideale Wortzahl oder eine verpflichtende Zerlegung in Miniabsätze gibt es nicht.
Kann ein Agent Ihre Website tatsächlich nutzen?
Ein Agent kann für einen Kunden Angebote vergleichen, Verfügbarkeit suchen oder eine Anfrage beginnen. Dafür braucht er klaren Text, aussagekräftige Beschriftungen, zugängliche Bedienelemente, verlässliche Navigation und verständliche Fehlermeldungen. Zeigen Sie wesentliche Preise und Bedingungen, kennzeichnen Sie Pflichtfelder und bieten Sie einen menschlichen Kontaktweg. Testen Sie den Ablauf auch mobil und mit der Tastatur.
Der Zugang zu einer öffentlichen Seite erlaubt weder das Umgehen einer Anmeldung noch das Auslesen privater Daten, den Abschluss eines Vertrags oder einen Kauf. Sensible Aktionen benötigen passende Authentifizierung, Berechtigungen und bewusste Bestätigung. CAPTCHA, Ratenbegrenzung und Missbrauchsschutz haben berechtigte Zwecke. Beseitigen Sie unnötige Hindernisse, ohne die Sicherheit abzubauen. Ein User-Agent-String allein beweist keine Identität.
Messen, was dem Unternehmen hilft
Beobachten Sie Indexierung, Suchberichte, verfügbare Verweise, Anfragen und Geschäftsergebnisse. Manche Assistenten übermitteln keine erkennbare Verweisquelle. Auch eine Erwähnung ohne Klick kann eine Entscheidung beeinflussen. Fragen Sie Kunden nach ihrem Weg zu Ihnen und behandeln Sie Antworten als Orientierung. Wiederholen Sie relevante Fragen in mehreren Sprachen und notieren Sie Datum und Dienst.
Eine erfolgreiche Bot-Anfrage beweist weder Indexierung noch Zitat oder Verkauf. Erfassen Sie einen Ausgangswert, verbessern Sie eine Seite, geben Sie dem erneuten Crawling Zeit und suchen Sie nach Mustern. Messen Sie datenschutzfreundlich.
Ein praktischer erster Nachmittag
- Listen Sie wichtige Seiten und Zielgruppen auf: Dienste, Produkte, Hilfe, Sprachen und lokale Informationen.
- Vergleichen Sie öffentliche robots.txt, Anbieterregeln und CDN-Einstellungen für Suche, Agenten und Training. Dokumentieren Sie Ihre Wahl.
- Prüfen Sie einige URLs auf Antwortstatus, Indexierung, Canonical, klare Inhalte und interne Links.
- Lassen Sie eine Person mobil und per Tastatur eine Antwort finden und eine Anfrage beginnen; testen Sie nach Möglichkeit auch einen Agenten.
- Verbessern Sie eine Seite mit konkreten Antworten, Nachweisen und einem nächsten Schritt. Prüfen Sie sie nach der Veröffentlichung erneut.
Digitrans hilft Unternehmen in Luxemburg bei Websites, Suchsichtbarkeit und KI-tauglichen Kundenwegen. Sprechen Sie mit uns über Ihre Website.
Häufige Fragen
Muss ich KI-Training für Sichtbarkeit in der KI-Suche erlauben?
Nicht unbedingt. Manche Anbieter trennen Suche und Training. OpenAI dokumentiert OAI-SearchBot und GPTBot getrennt. Prüfen Sie aktuelle Regeln und Crawler mit mehreren Zwecken.
Garantiert GPTBot eine Empfehlung in ChatGPT?
Nein. GPTBot betrifft mögliches Modelltraining. Die Suche verwendet separate Systeme und Regeln. Zugang garantiert weder Empfehlung noch Zitat.
Soll ich alle KI-Agenten blockieren?
Das hängt von Ihren Diensten und Risiken ab. Agenten können Kunden bei öffentlichen Informationen helfen. Schützen Sie private Daten und sensible Aktionen und testen Sie berechtigten Zugang.
Ist das gemeinsame Trainingssignal bereits verpflichtend?
Nein. Der zitierte Vorschlag ist ein Internetentwurf und die angekündigte Unterstützung freiwillig und zukünftig. Zeitpläne können sich ändern.
Verbessert llms.txt Googles KI-Rankings?
Google sagt, dass Search llms.txt nicht verwendet. Andere Systeme können sie als Index nutzen. Sie ersetzt keine zugänglichen und hilfreichen Seiten.
Kann Digitrans bei der KI-Sichtbarkeit helfen?
Ja. Wir können Zugang, SEO-Grundlagen, Inhalte und Agentenabläufe prüfen und passende Verbesserungen umsetzen. Kein Anbieter kann eine bestimmte KI-Antwort oder Platzierung garantieren.